7.4 Ejemplos
En esta sección nos centraremos en el bootstrap en la estimación tipo núcleo de la función de regresión, para la aproximación de la precisión y el sesgo, y también para el cálculo de intervalos de confianza y de predicción.
7.4.1 Bootstrap residual
El modelo ajustado de regresión se puede emplear para estimar la respuesta media \(m(x_0)\) cuando la variable explicativa toma un valor concreto \(x_0\). En este caso también podemos emplear el bootstrap residual (Sección 3.7.2) para realizar inferencias acerca de la media. La idea sería aproximar la distribución del error de estimación \(\hat{m}_h(x_0) - m(x_0)\) por la distribución bootstrap de \(\hat{m}^{\ast}_h(x_0) - \hat{m}_g(x_0)\).
Para reproducir adecuadamente el sesgo del estimador, la ventana \(g\) debería ser asintóticamente mayor que \(h\) (de orden \(n^{-1/5}\)).
Análogamente al caso de la densidad, la recomendación sería emplear la ventana óptima para la estimación de \(m^{\prime \prime }\left( x_0 \right)\), de orden \(n^{-1/9}\) (Sección 7.2.1).
Sin embargo, en la práctica es habitual emplear \(g=h\) para evitar la selección de esta ventana (lo que además facilita emplear herramientas como el paquete boot).
Otra alternativa podría ser asumir que \(g \simeq n^{1/5}h/n^{1/9}\) como se hace a continuación.
n <- length(x)
g <- h * n^(4/45) # h*n^(-1/9)/n^(-1/5)
# g <- h
fitg <- locpoly(x, y, bandwidth = g) # puntos de estimación/predicción
# fitg$y <- predict(fitg, newdata = fitg$x)
estg <- approx(fitg, xout = x)$y # puntos observaciones
# estg <- predict(fitg)
# resid2 <- y - estg # resid2 <- residuals(fitg)

# Remuestreo
set.seed(1)
B <- 2000
stat_fit_boot <- matrix(nrow = length(fit$x), ncol = B)
resid0 <- resid - mean(resid)
for (k in 1:B) {
    y_boot <- estg + sample(resid0, replace = TRUE)
    fit_boot <- locpoly(x, y_boot, bandwidth = h)$y
    stat_fit_boot[ , k] <- fit_boot - fitg$y
}

# Calculo del sesgo y error estándar
bias <- apply(stat_fit_boot, 1, mean)
std.err <- apply(stat_fit_boot, 1, sd)

# Representar estimación y corrección de sesgo bootstrap
plot(x, y)
lines(fit, lwd = 2)
lines(fit$x, fit$y - bias)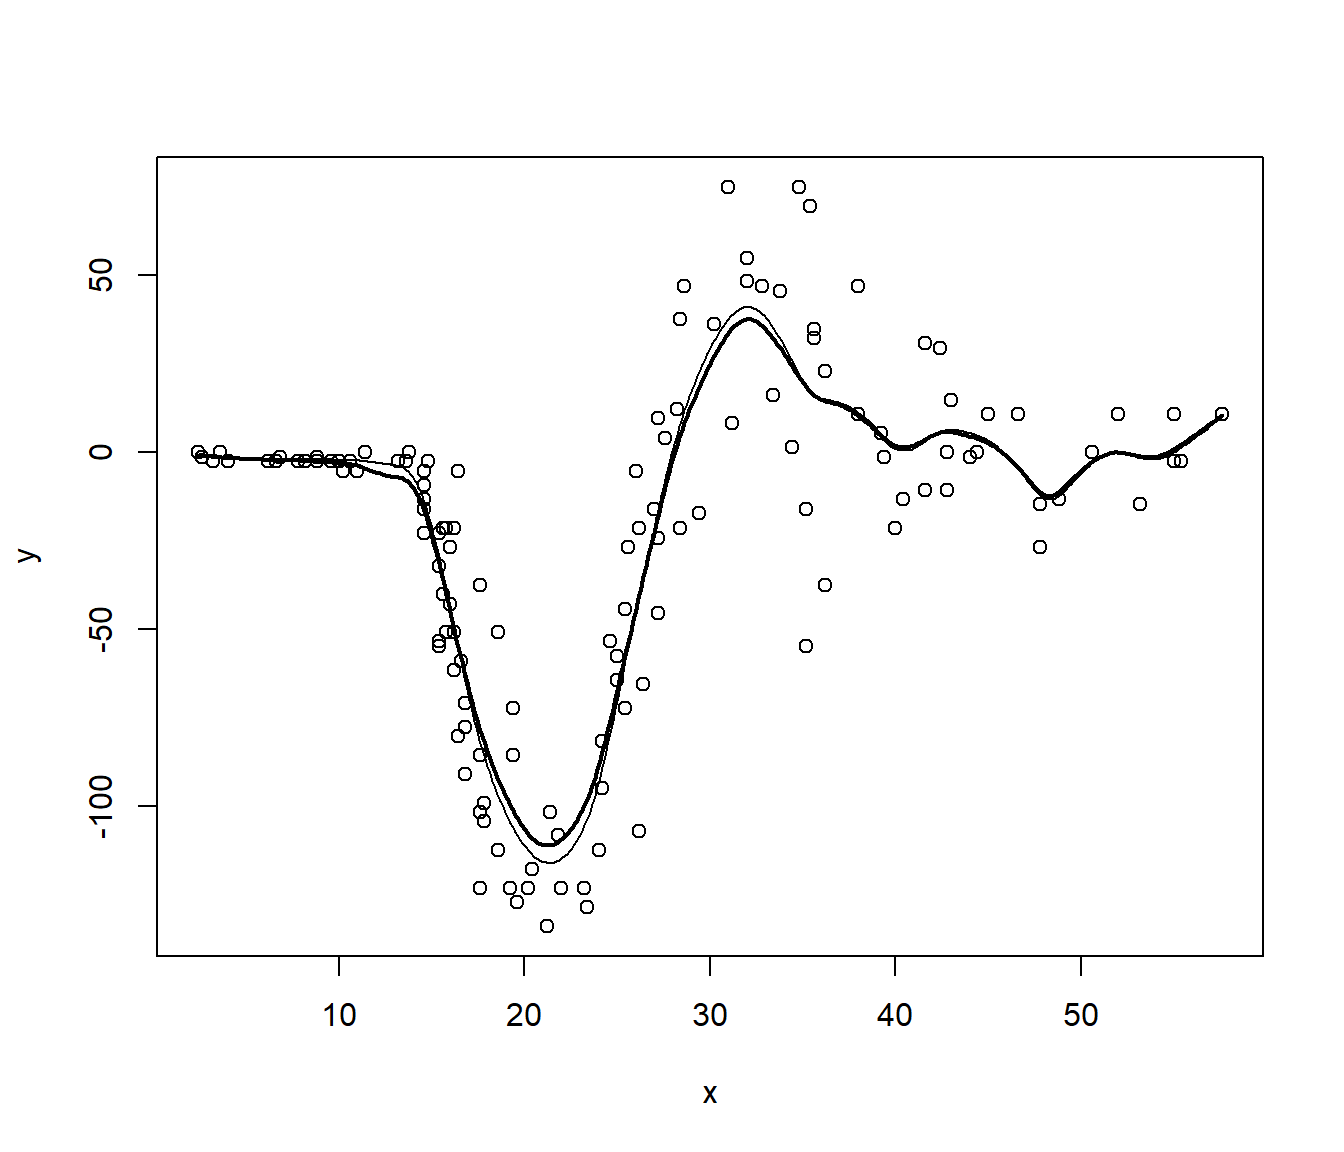
NOTA: De forma análoga al caso lineal (Sección 3.7.2), se podrían reescalar los residuos a partir de la matriz de suavizado (empleando los paquetes sm o npsp).
7.4.2 Intervalos de confianza y predicción
De forma análoga al caso de la estimación de la densidad mostrado en la Sección 6.6.2, podemos calcular estimaciones por intervalo de confianza (puntuales) por el método percentil (básico):
alfa <- 0.05
pto_crit <- apply(stat_fit_boot, 1, quantile, probs = c(alfa/2, 1 - alfa/2))
ic_inf_boot <- fit$y - pto_crit[2, ]
ic_sup_boot <- fit$y - pto_crit[1, ]

plot(x, y)
lines(fit, lwd = 2)
lines(fit$x, fit$y - bias)
lines(fit$x, ic_inf_boot, lty = 2)
lines(fit$x, ic_sup_boot, lty = 2)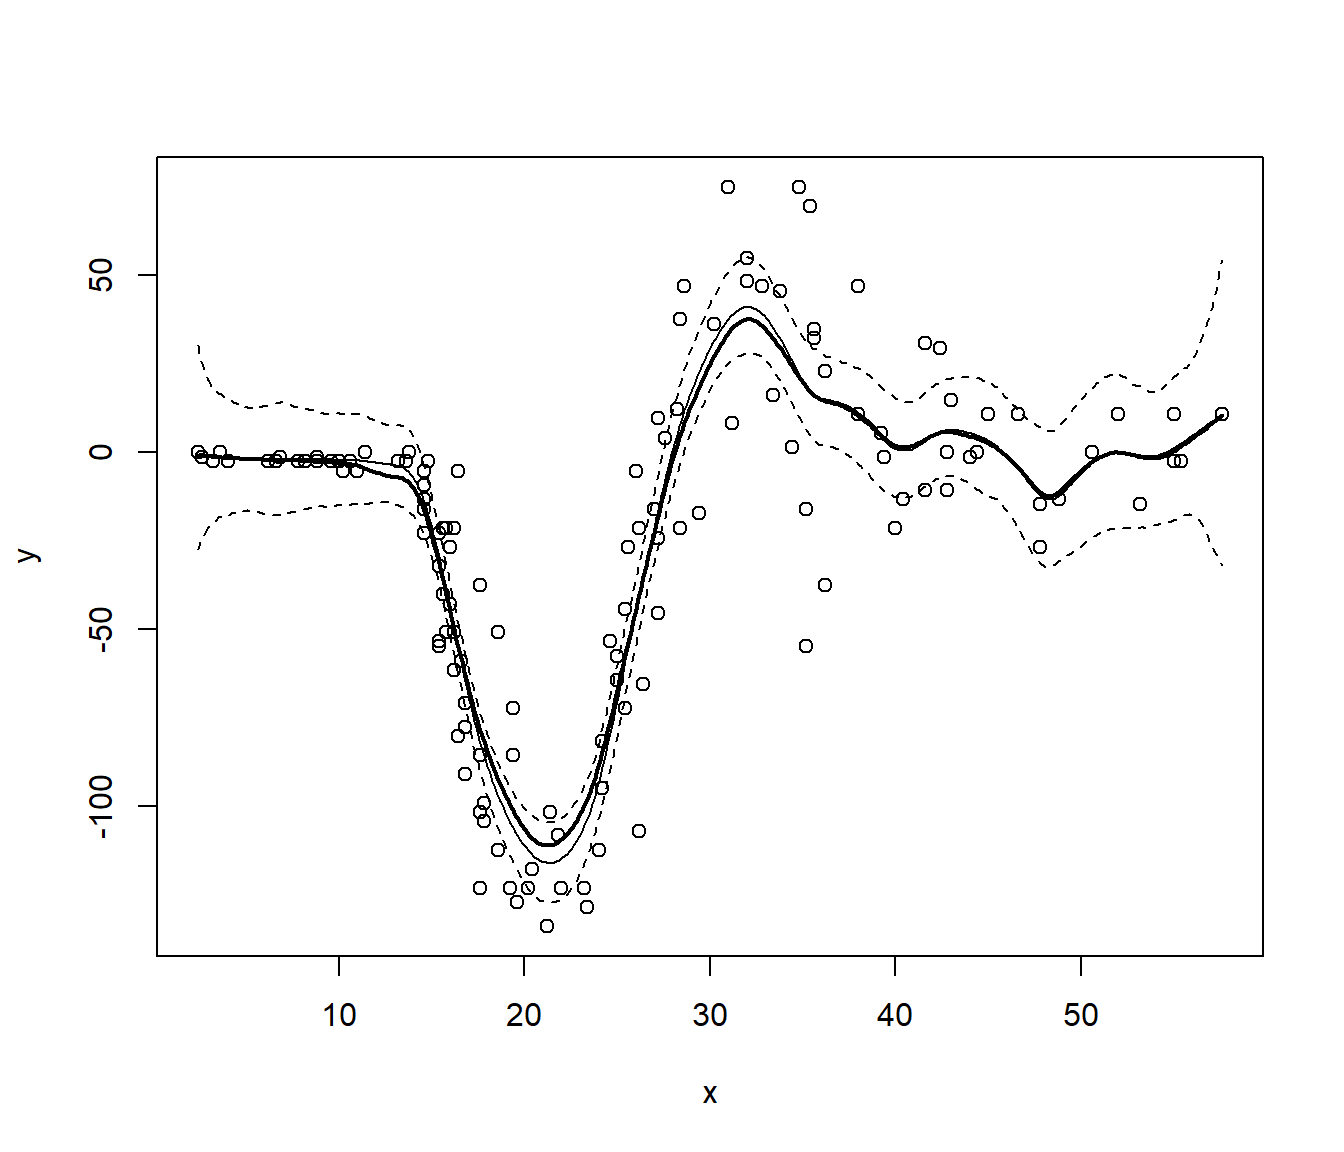
El modelo ajustado también es empleado para predecir una nueva respuesta individual \(Y(x_0)\) para un valor concreto \(x_0\) de la variable explicativa.
En el caso de errores independientes \(\hat{Y}(x_0) = \hat{m}_h(x_0)\), pero si estamos interesados en realizar inferencias sobre el error de predicción \(r(x_0) = Y(x_0) - \hat{Y}(x_0)\), a la variabilidad de \(\hat{m}_h(x_0)\) debida a la muestra, se añade la variabilidad del error \(\varepsilon(x_0)\).
La idea sería aproximar la distribución del error de predicción: \[r(x_0) = Y(x_0) - \hat{Y}(x_0) = m(x_0) + \varepsilon(x_0) - \hat{m}_h(x_0)\] por la distribución bootstrap de: \[r^{\ast}(x_0) = Y^{\ast}(x_0) - \hat{Y}^{\ast}(x_0) = \hat{m}_g(x_0) + \varepsilon^{\ast}(x_0) - \hat{m}^{\ast}_h(x_0)\]
# Remuestreo
set.seed(1)
n_pre <- length(fit$x)
stat_pred_boot <- matrix(nrow = n_pre, ncol = B)
for (k in 1:B) {
    y_boot <- estg + sample(resid0, replace = TRUE)
    fit_boot <- locpoly(x, y_boot, bandwidth = h)$y
    pred_boot <- fitg$y + sample(resid0, n_pre, replace = TRUE)
    stat_pred_boot[ , k] <- pred_boot - fit_boot
}

# Cálculo de intervalos de predicción
# por el método percentil (básico)
alfa <- 0.05
pto_crit_pred <- apply(stat_pred_boot, 1, quantile, probs = c(alfa/2, 1 - alfa/2))
ip_inf_boot <- fit$y + pto_crit_pred[1, ]
ip_sup_boot <- fit$y + pto_crit_pred[2, ]

plot(x, y, ylim = c(-150, 75))
lines(fit, lwd = 2)
lines(fit$x, fit$y - bias)
lines(fit$x, ic_inf_boot, lty = 2)
lines(fit$x, ic_sup_boot, lty = 2)
lines(fit$x, ip_inf_boot, lty = 3)
lines(fit$x, ip_sup_boot, lty = 3)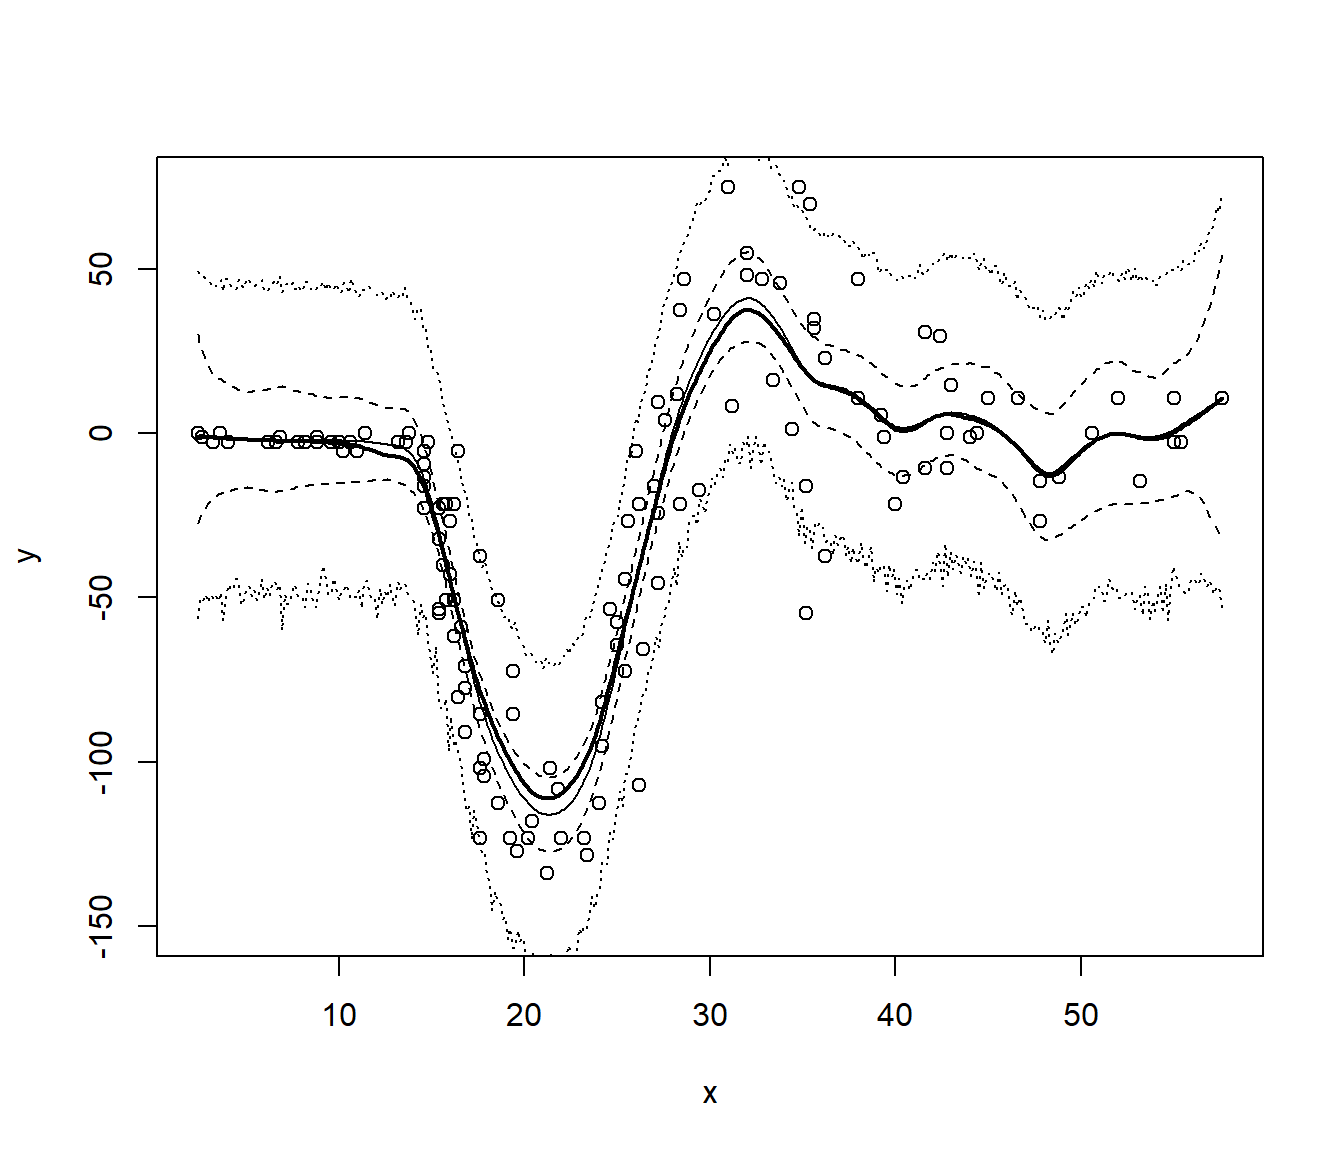
En este caso puede no ser recomendable considerar errores i.i.d., sería de esperar heterocedásticidad (e incluso dependencia temporal). El bootstrap residual se puede extender al caso heterocedástico y/o dependencia (e.g. Castillo-Páez et al., 2019, 2020).
7.4.3 Wild bootstrap
En el caso heterocedástico se suele considerar como base el siguiente modelo general: \[Y = m(\mathbf{X}) + \sigma(\mathbf{X}) \varepsilon,\] siendo \(m(\mathbf{x}) = E\left( \left. Y\right\vert_{\mathbf{X}=\mathbf{x}} \right)\) la media condicional (denominada función de regresión o tendencia), \(\sigma^2(\mathbf{x}) = Var\left( \left. Y\right\vert_{\mathbf{X}=\mathbf{x}} \right)\) la varianza condicional y \(\varepsilon\) es un error aleatorio de media cero y varianza unidad.
Como se describe en la Sección 7.2.1 en este caso puede ser adecuado emplear wild bootstrap.
# Remuestreo
set.seed(1)
B <- 1000
fit_boot <- matrix(nrow = n_pre, ncol = B)
for (k in 1:B) {
        rwild <- sample(c((1 - sqrt(5))/2, (1 + sqrt(5))/2), n, replace = TRUE,
                        prob = c((5 + sqrt(5))/10, 1 - (5 + sqrt(5))/10))
    y_boot <- estg + resid*rwild
    fit_boot[ , k] <- locpoly(x, y_boot, bandwidth = h)$y
    # OJO: bootstrap percetil directo
}


# Calculo del sesgo y error estándar
bias <- apply(fit_boot, 1, mean, na.rm = TRUE) - fitg$y
std.err <- apply(fit_boot, 1, sd, na.rm = TRUE)

# Representar estimación y corrección de sesgo bootstrap
plot(x, y)
lines(fit, lwd = 2)
lines(fit$x, fit$y - bias)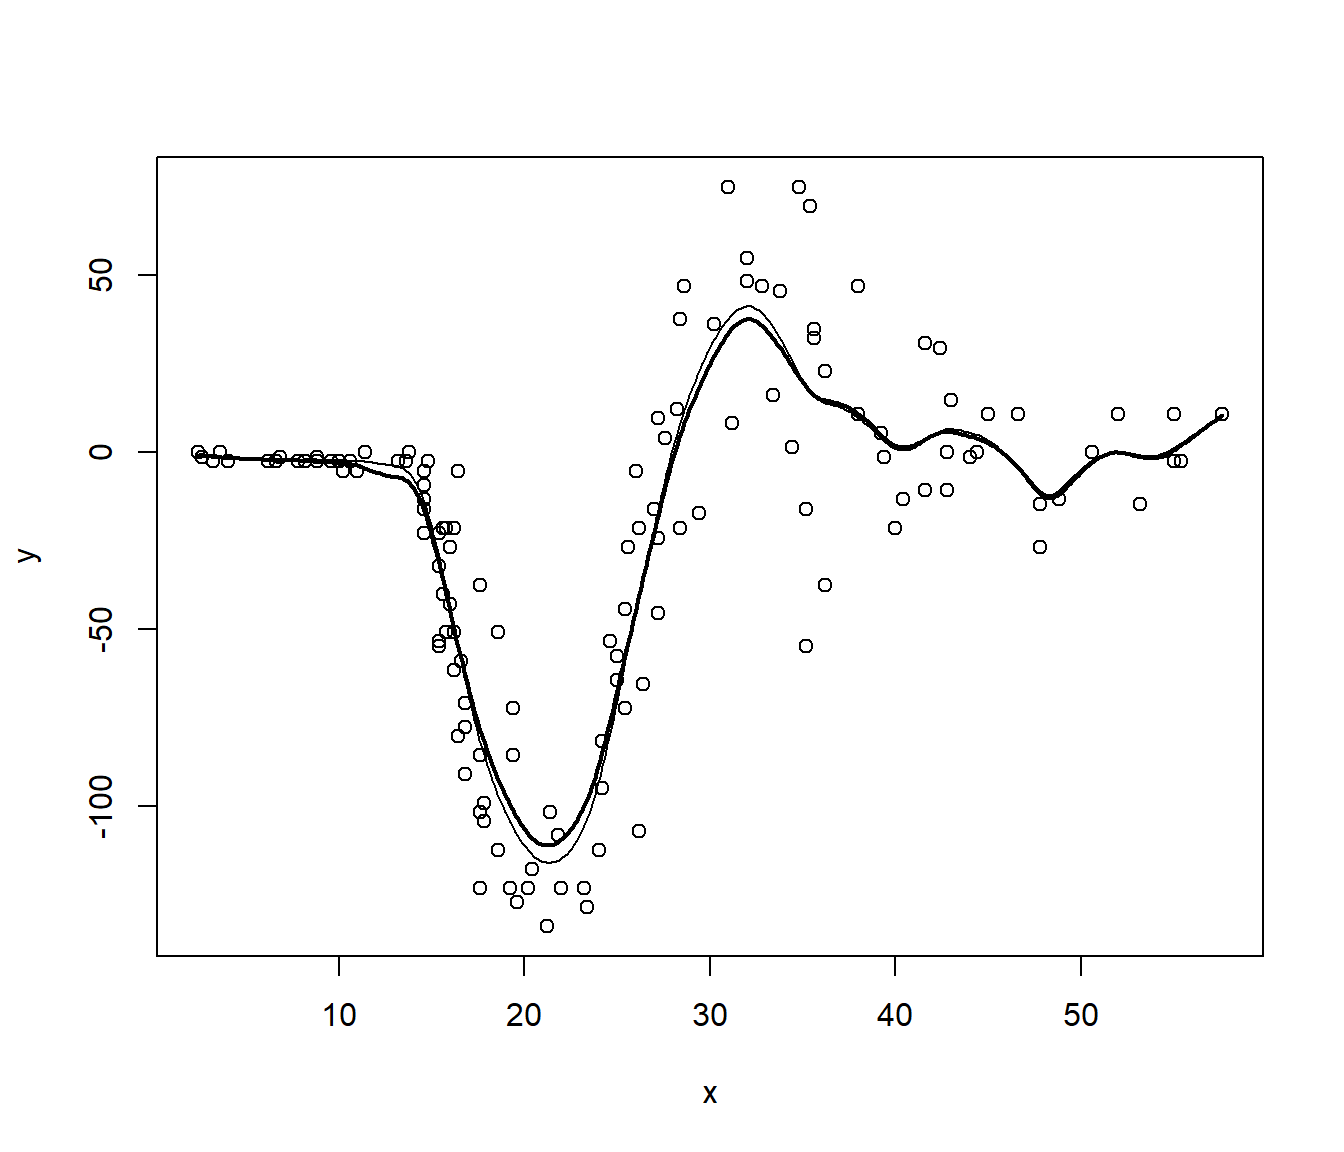
Ejercicio 7.1 Siguiendo con el conjunto de datos MASS::mcycle, emplear wild bootstrap para
obtener estimaciones por intervalo de confianza de la función de regresión
de accel a partir de times mediante bootstrap percentil básico.
Comparar los resultados con los obtenidos mediante bootstrap residual (comentar las diferencias y cuál de las aproximaciones sería más adecuada para este caso).
7.4.4 Bootstrap heterocedástico residual
En el caso heterocedástico, como alternativa al wild bootstrap, también podemos emplear bootstrap residual, aunque para ello será necesario modelar además la varianza condicional.
En este apartado consideraremos la estimación no paramétrica de la tendencia y de la varianza, aunque el procedimiento bootstrap sería análogo en el caso de modelos paramétricos. La tendencia se puede estimar empleando el estimador polinómico local, aunque lo ideal sería utilizar una ventana local que tenga en cuenta la varianza condicional11. La recomendación para estimar no paramétricamente la varianza condicional es suavizar los residuos al cuadrado (Fan y Yao, 1998). Para resolver este problema circular se podría seguir un procedimiento iterativo.
Continuaremos utilizando como ejemplo el conjunto de datos MASS::mcycle y
las herramientas del paquete KernSmooth.
Por comodidad utilizaremos la misma ventana global “óptima” del caso homocedástico (evitando el problema circular):
h <- dpill(x, y) # Método plug-in de Ruppert, Sheather y Wand (1995)
fit <- locpoly(x, y, bandwidth = h) # Estimación lineal local
plot(x, y)
lines(fit)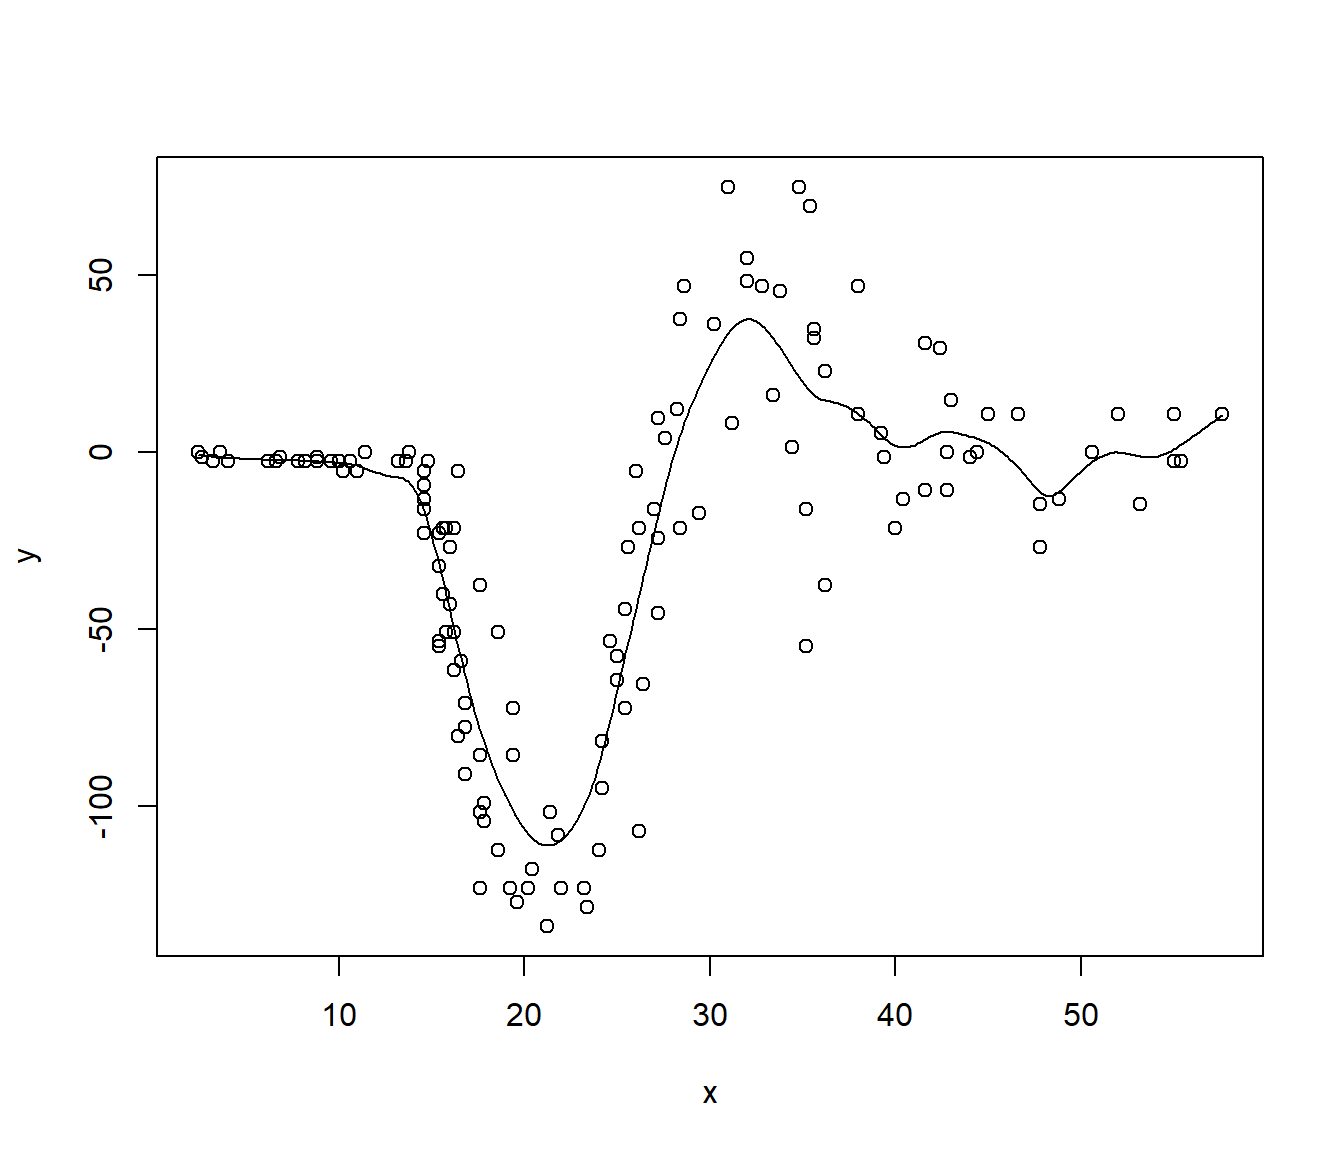
Obtenemos estimaciones de la tendencia y los residuos (heterocedásticos)
trend.est <- approx(fit, xout = x)$y # trend.est <- predict(fit)
resid <- y - trend.est # resid <- residuals(fit)
Obtenemos un estimador de la varianza condicional suavizando los residuos al cuadrado:
r2 <- resid^2
g <- dpill(x, r2) # No es la ventana óptima para estimar la varianza
fit.var <- locpoly(x, r2, bandwidth = g)
# En este caso igual es preferible emplear Nadaraya-Watson (degree = 0)
# var.est <- pmax(approx(fit.var, xout = x)$y, 0)
plot(x, r2)
lines(fit.var)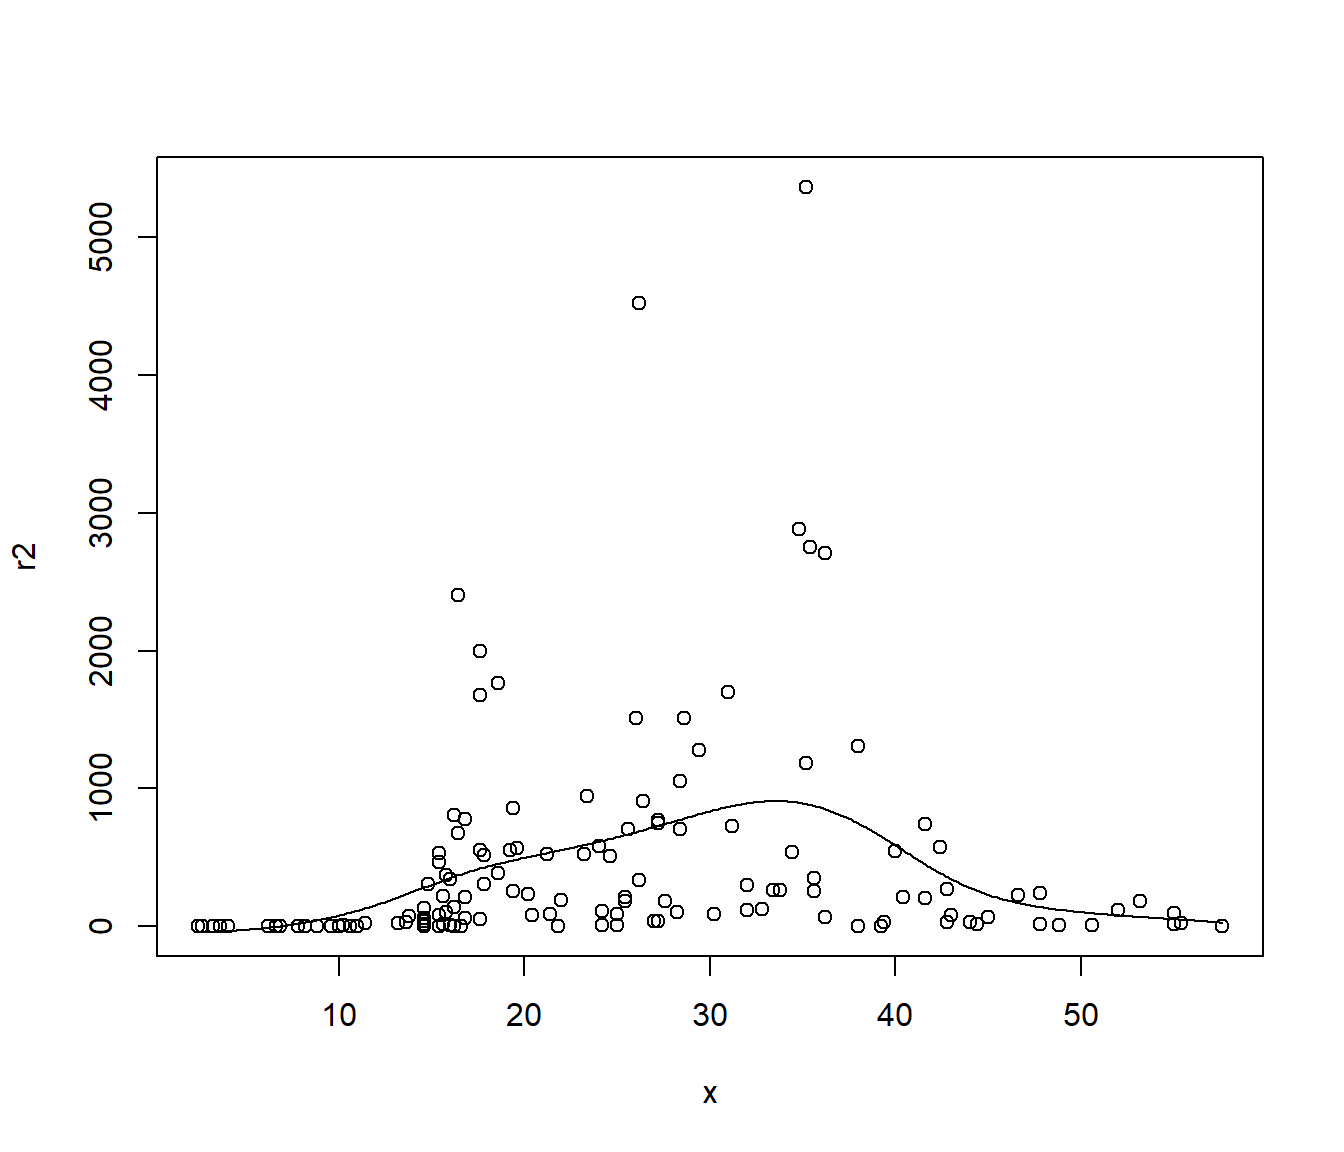
Otra alternativa sería hacer el suavizado en escala logarítmica (empleando log(r2)
en lugar de r2 y transformando el resultado a la escala original mediante exp();
aunque podría ser preferible emplear la raíz cuarta sqrt(abs(resid))).
g <- dpill(x, log(r2))
fit.var <- locpoly(x, log(r2), bandwidth = g)
# La distribución de los residuos va a ser más simétrica
# hist(approx(fit.var, xout = x)$y - log(r2))
fit.var$y <- exp(fit.var$y)
plot(x, r2)
lines(fit.var)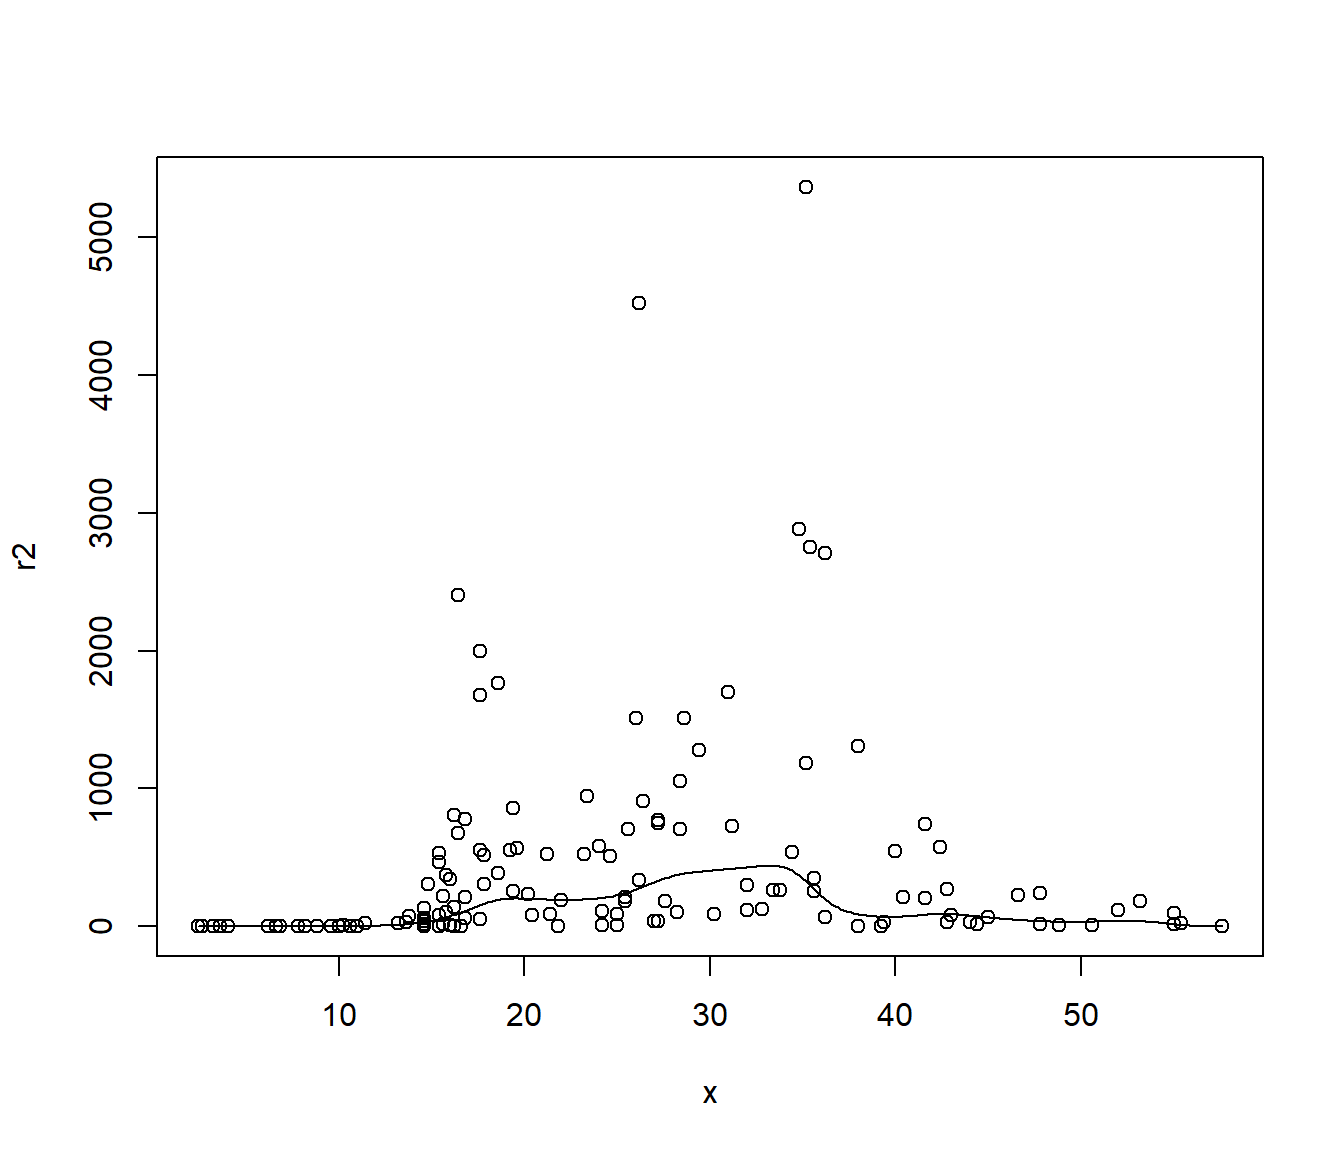
# g <- dpill(x, sqrt(abs(resid)))
# fit.var <- locpoly(x, sqrt(abs(resid)), bandwidth = g)
# # La distribución de los residuos va a ser mucho más simétrica
# # hist(approx(fit.var, xout = x)$y - sqrt(abs(resid)))
# fit.var$y <- fit.var$y^4
# plot(x, r2)
# lines(fit.var)
Normalmente emplearemos la desviación típica condicional:
La representamos junto con la media a título ilustrativo (no confundirla con el error estándar de la estimación de la tendencia):
En el bootstrap heterocedástico residual los errores \(\hat{\varepsilon}_i^{\ast}\) se generan mediante remuestreo de los residuos studentizados: \[e_i = \frac{Y_i - \hat{m}_{h}( X_i )}{\hat{\sigma}_{g}(X_i)}\] (centrados y reescalados).
A continuación, usando dos ventanas piloto \(h_2\) y \(g_2\), se generan las réplicas bootstrap:
\[Y_i^{\ast}=\hat{m}_{h_2}(X_i) + \hat{\sigma}_{g_2}(X_i)\hat{\varepsilon}_i^{\ast} \text{, } i=1, 2,\ldots ,n\]
Para realizar inferencias acerca de la media, se aproximaría la distribución \(\hat{m}_h(x_0) - m(x_0)\) por la distribución bootstrap de \(\hat{m}^{\ast}_h(x_0) - \hat{m}_{h_2}(x_0)\). De forma análoga, Para realizar inferencias acerca de la varianza, se aproximaría la distribución \(\hat{\sigma}^2_g(x_0) - \sigma^2(x_0)\) por la distribución bootstrap de \(\hat{\sigma}^{2\ast}_g(x_0) - \hat{\sigma}^2_{g_2}(x_0)\).
Por simplicidad, en lugar de considerar dos ventanas adicionales, emplearemos la aproximación habitual en la práctica y consideraremos \(h_2 = h\) y \(g_2 = g\).
# Remuestreo
set.seed(1)
B <- 2000
stat_trend_boot <- matrix(nrow = length(fit$x), ncol = B)
sresid <- resid/sd.est
# mean(sresid); sd(sresid)
sresid <- scale(sresid)

for (k in 1:B) {
    y_boot <- trend.est + sd.est*sample(sresid, replace = TRUE)
    fit_boot <- locpoly(x, y_boot, bandwidth = h)$y
    stat_trend_boot[ , k] <- fit_boot - fit$y
}

# Calculo del sesgo y error trend.estándar
bias <- apply(stat_trend_boot, 1, mean)
std.err <- apply(stat_trend_boot, 1, sd)

# Representar estimación y corrección de sesgo bootstrap
plot(x, y)
lines(fit, lwd = 2)
lines(fit$x, fit$y - bias)

# A modo de ejemplo IC `type = "norm"`, con corrección de sesgo
alfa <- 0.05
z <- qnorm(1 - alfa/2)
lines(fit$x, fit$y - bias - 2*std.err, lty = 2)
lines(fit$x, fit$y - bias + 2*std.err, lty = 2)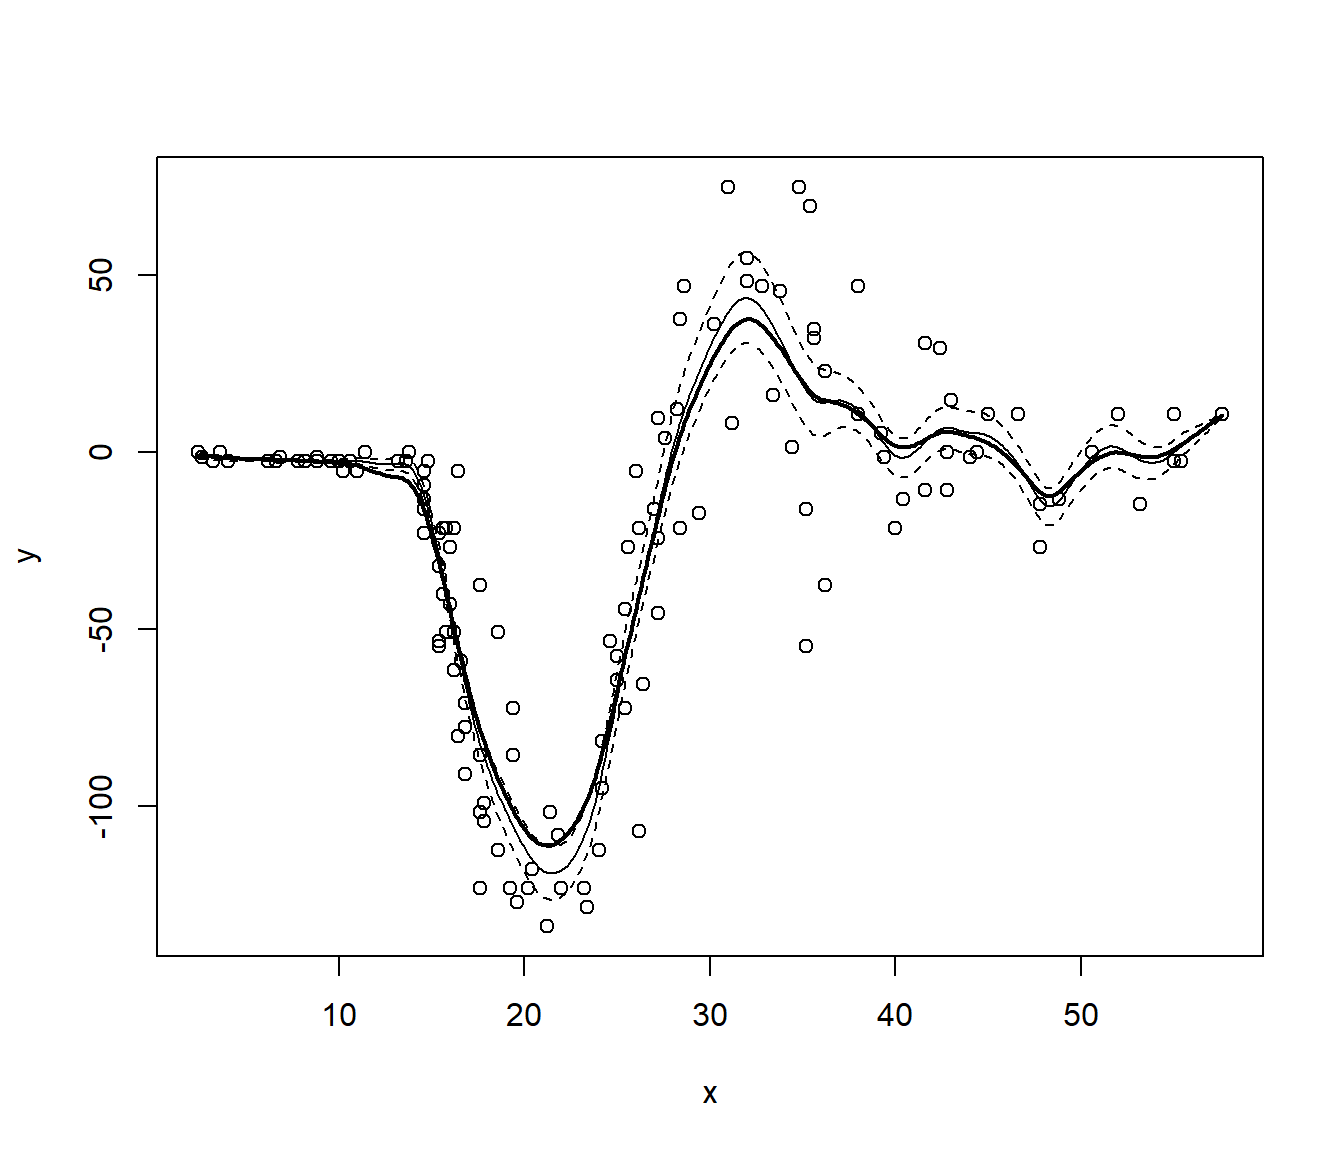
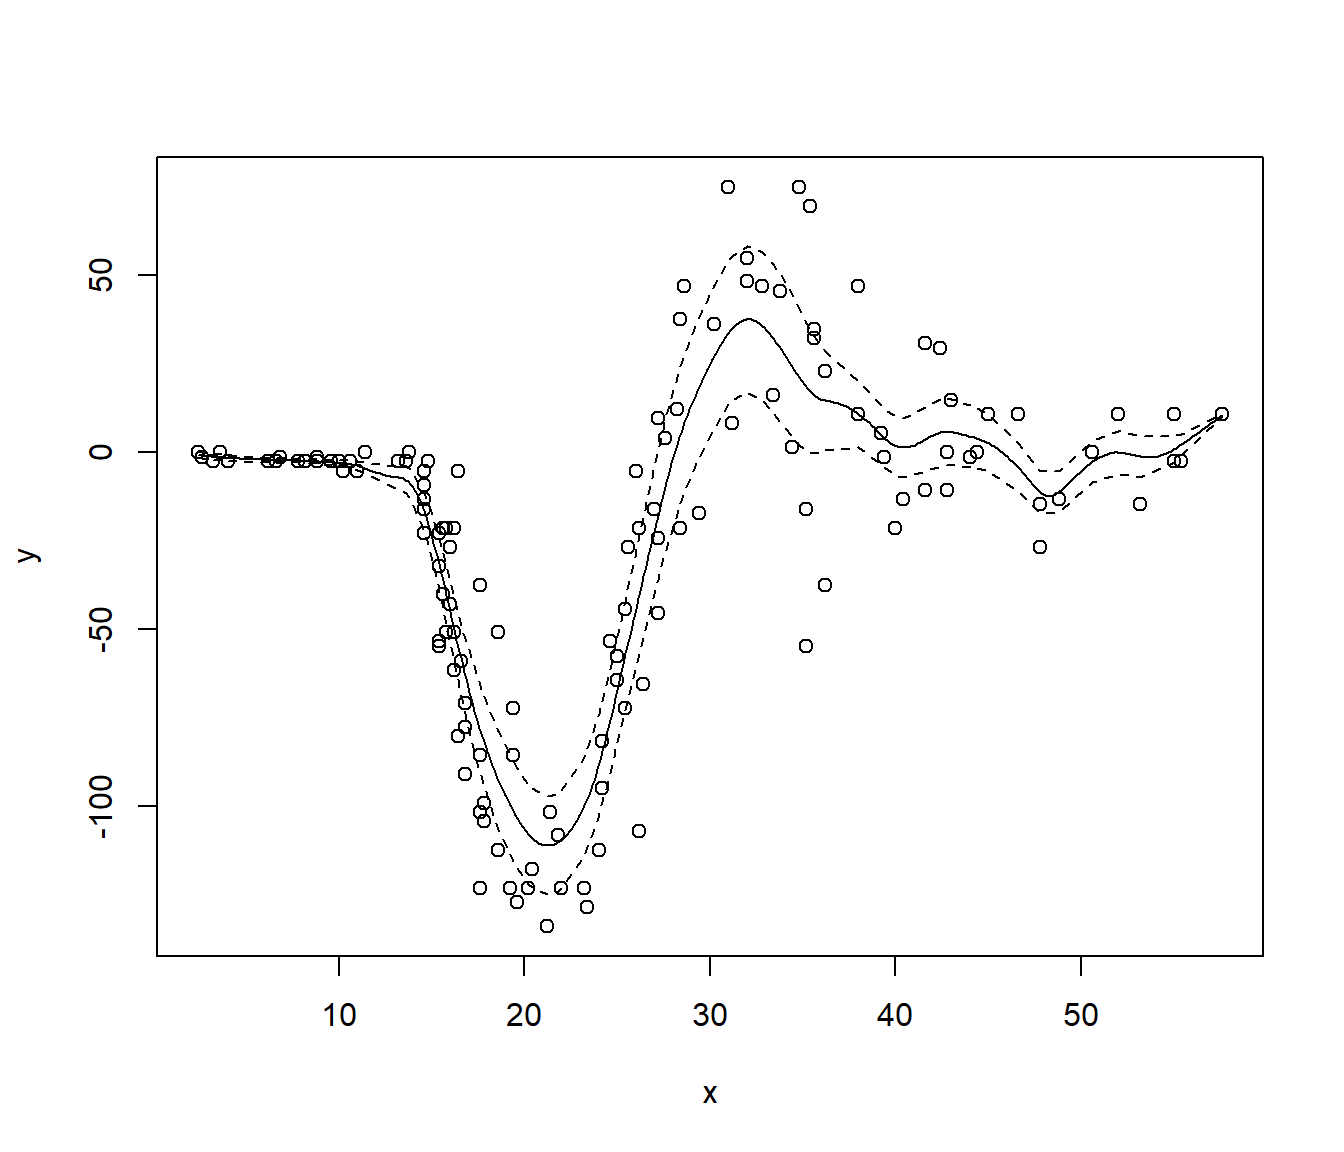
De forma análoga al caso homocedástico, podemos calcular estimaciones por intervalo de confianza (puntuales) por el método percentil (básico):
alfa <- 0.05
pto_crit <- apply(stat_trend_boot, 1, quantile, probs = c(alfa/2, 1 - alfa/2))
ic_inf_boot <- fit$y - pto_crit[2, ]
ic_sup_boot <- fit$y - pto_crit[1, ]

plot(x, y)
lines(fit, lwd = 2)
lines(fit$x, fit$y - bias)
lines(fit$x, ic_inf_boot, lty = 2)
lines(fit$x, ic_sup_boot, lty = 2)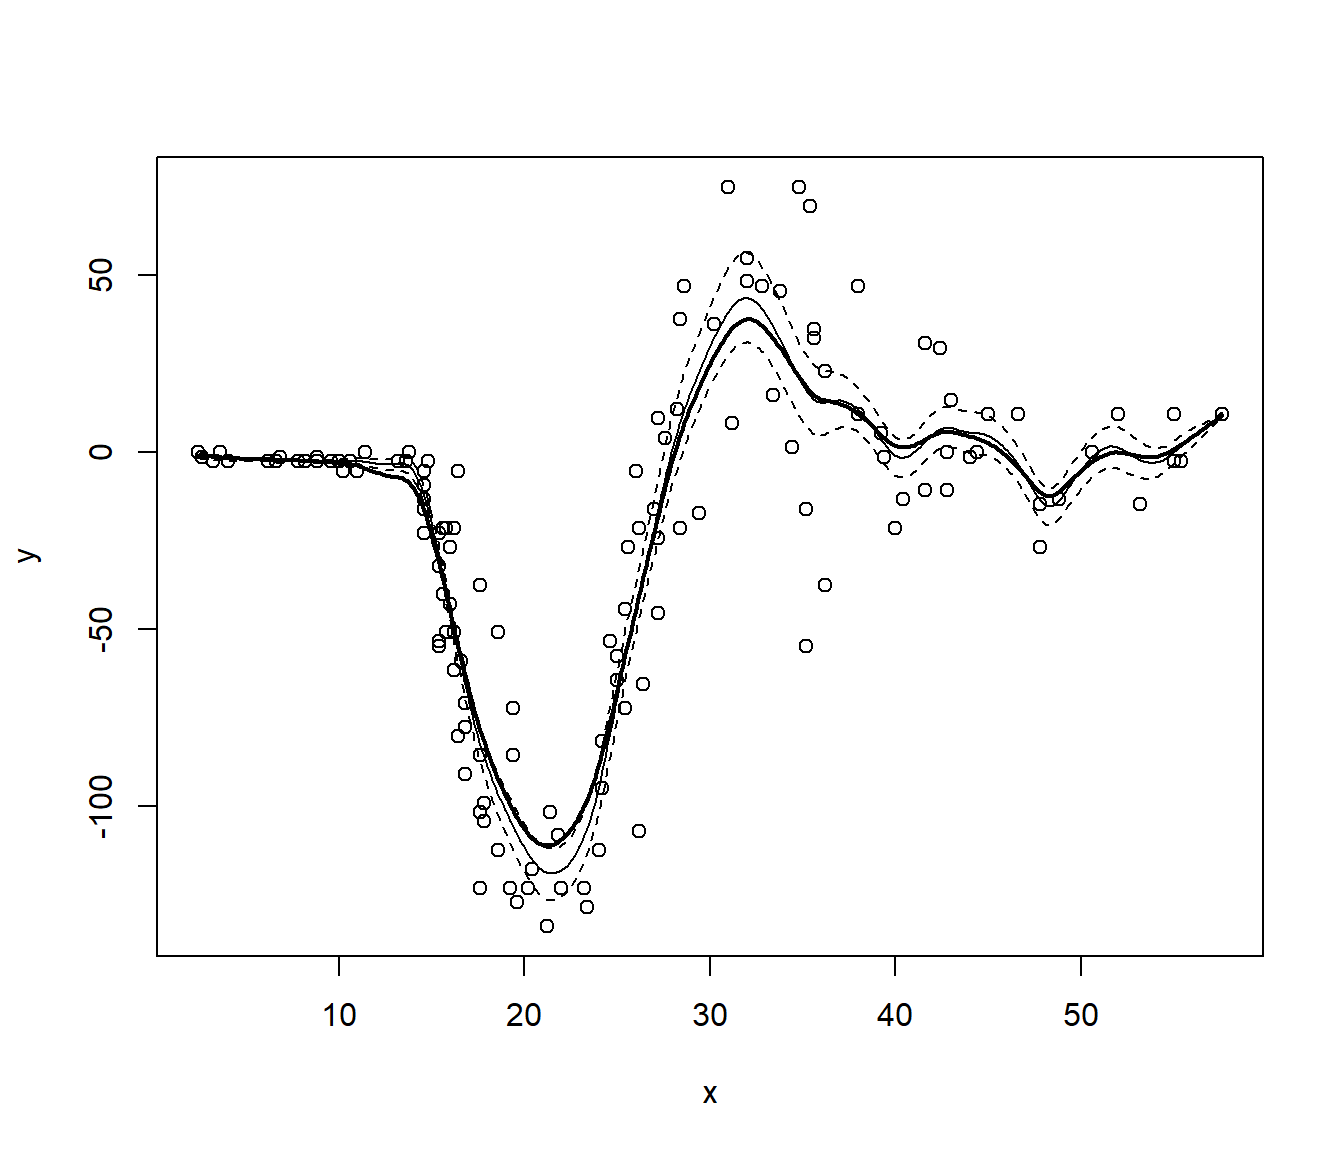
En este ejemplo concreto podría ser recomendable considerar también errores con dependencia temporal (ver e.g. material suplementario de Fernández-Casal et al., 2024).
Ejercicio 7.2 Siguiendo con el ejemplo anterior, obtener intervalos de predicción mediante bootstrap heterocedástico residual.
KernSmoothadmite ventanas locales pero no implementa métodos para seleccionarlas. El paquetenpdispone de más herramientas (ver e.g. García-Portugués, 2025, Sección 4.5); aunque tampoco implementa criterios óptimos para datos homocedásticos, que tengan en cuenta la varianza condicional.↩︎